해커뉴스에 "104GB 모델을 48GB 맥에서 초당 12토큰으로 돌린다" 는 글이 올라와 235점을 받고 있었습니다. 도구 이름은 slotstream입니다.
저희가 이 대목에 예민한 이유가 있어요. 전에 배너를 만들면서 그래픽카드 메모리는 24GB인데 모델 파일이 30.4GB라 안 들어가서, 파일을 왔다 갔다 옮기느라 첫 장이 느렸던 걸 재본 적이 있습니다. 6GB가 모자라서 겪은 일이었어요.
여기는 89GB가 모자란데 된다고 합니다. 어떻게 하는 건지 궁금해서 저장소를 열었습니다.
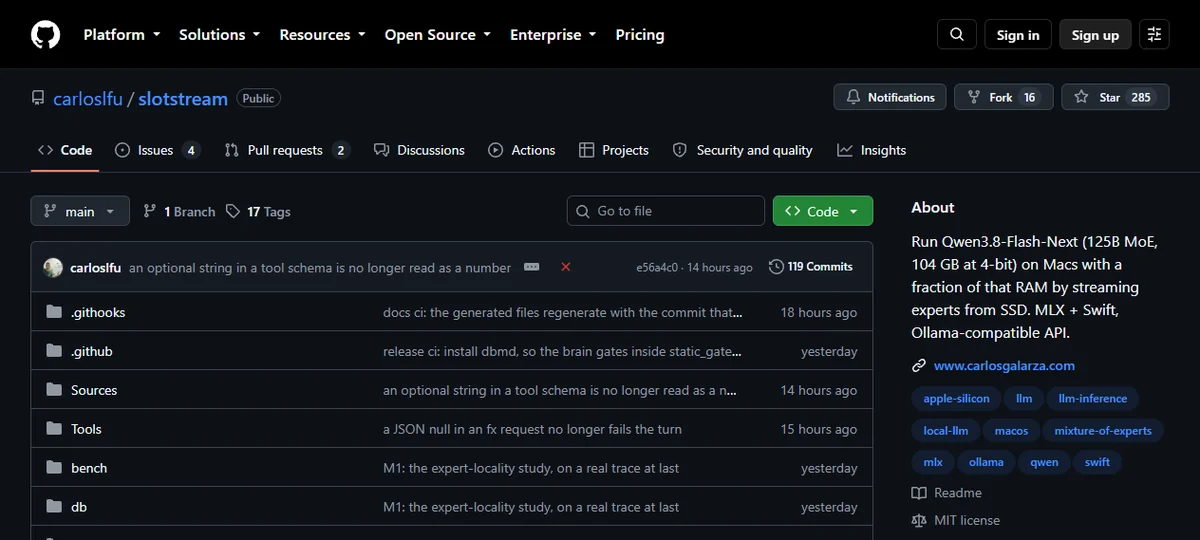
2026년 9월 4일에 캡처했습니다. 지금은 별이 293개로 늘었고 MIT 라이선스입니다. 태그에 apple-silicon, mixture-of-experts가 걸려 있습니다.
layer 마다 512개 중 10개만 켜집니다
대상 모델은 Qwen3.8-Flash-Next이고 파라미터가 1,250억 개입니다. 4비트로 줄여 받아도 파일이 105.3GB예요.
그런데 이 모델은 속이 통짜가 아닙니다. layer1가 48개 있고, layer 마다 작은 덩어리가 512개씩 들어 있어요. token2 하나를 만들 때 그중 10개만 켜집니다. 이 덩어리를 expert3, 이런 구조를 MoE4라고 부릅니다.
slotstream MEASUREMENTS.md 에 적힌 layer 48개 · layer 당 expert 512개 · token 당 활성 10개를 그린 것입니다.
여기까지 읽고 나서야 89GB 차이가 이해됐어요. 통짜였다면 전부 올려야 하니 방법이 없는데, 이건 안 쓰는 부분이 대부분인 구조라 그때그때 읽어 오면 됩니다. 디스크에는 105.3GB를 다 받아둬야 하지만 메모리에 상주하는 건 3.822GB뿐입니다.
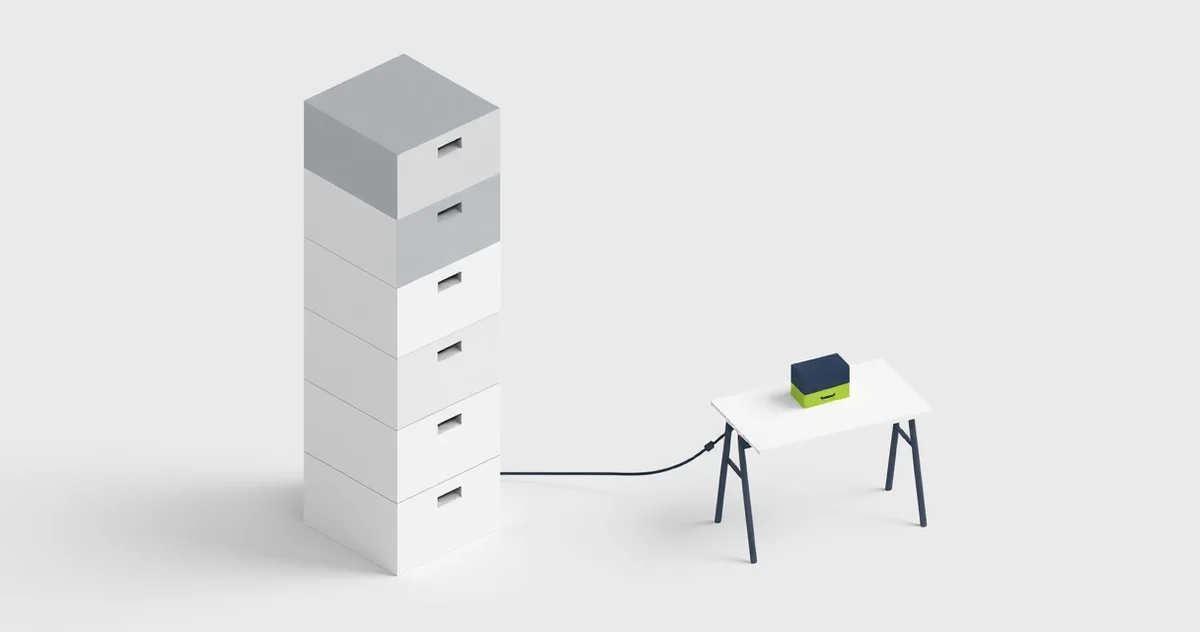
디스크에는 105.3GB를 다 받아두고 그때그때 필요한 것만 꺼내 옵니다. 메모리에 늘 올려두는 건 3.8GB뿐입니다.
표에 적힌 4토큰과 실제로 나온 1.41토큰
표가 말한 값과 실제로 잰 값의 차이입니다. 표는 초당 4토큰, 16GB 맥 미니에서 실제로 나온 건 1.41토큰이었습니다.
README에 램 크기별 속도가 표로 있습니다. 16GB에서 초당 4토큰, 24GB에서 8토큰, 48GB에서 12토큰.
그 아래에 이렇게 적어뒀습니다.
추정치는 실제 맥에서 잰 결과와 상당히 다를 수 있습니다. 기본 저장장치를 쓰는 16GB 맥 미니 M2는 초당 1.41토큰이 나왔고, 128GB M5 Max는 M5 Pro 추정치보다 빨랐습니다.
표의 4토큰과 실측 1.41토큰은 세 배 차이입니다. 그런데 그 사실을 표 바로 아래 자기 손으로 적어뒀어요.
해커뉴스에는 더 낮은 값도 있었습니다. jedbrooke는 M2 맥 미니 16GB에서 해봤는데 가중치를 USB 디스크에 둬야 했고 초당 0.5토큰이 나왔다고 적었습니다. 디스크가 초당 400MB에서 꽉 차는 게 보인다며, expert를 여기저기서 읽느라 그런 것 같다고 덧붙였어요.
prometheus1992는 아예 못 믿겠다고 했습니다. 자기는 16GB M3에서 다른 모델로 초당 7~8토큰을 내는데 발열 경고를 관리하면서 그렇다고요. trollbridge는 32GB도 빠듯하다고 했습니다. OS가 8GB를 먹는다는 이유였어요.
성공 기록이 아니라 실패 기록이 재미있었습니다
저장소에 MEASUREMENTS.md라는 파일이 있습니다. 159,112자짜리 작업 일지예요. 재본 값과 재는 방법, 그리고 안 됐던 것이 날짜별로 적혀 있습니다.
처음에는 파일을 메모리에 매핑해두고 필요한 조각만 느긋하게 읽어오려 했다고 합니다. 안 됐어요.
MLX는 메모리에 매핑한 텐서를 부분만 실체화하지 못한다.
느긋하게 불러온 배열 위에서 gather 연산을 돌렸더니 원본 텐서가 통째로 올라왔어요. 두 경로를 따로 쟀는데 숫자가 이렇습니다.
- expert를 모을 때: 27.6MB가 필요한데 471.9MB가 올라왔다 — 17배
- n-gram 표에서 16행을 꺼낼 때: 1.3KB가 필요한데 200MB가 올라왔다 — 15만 배
이 한 줄 때문에 설계가 바뀌었습니다. 크기가 정해진 칸을 미리 잡아두고 거기에 expert를 읽어 넣는 slot pool5이, "이렇게 하면 더 빠르다"에서 "이렇게 안 하면 안 된다"로 바뀐 겁니다.
느린 건 디스크가 아니었습니다
SSD는 초당 17.3GB로 넉넉히 흘려보내는데 그 뒤 계산 쪽에서 막힙니다. 좁은 곳은 관이 아니라 밸브였습니다.
저는 당연히 SSD가 발목을 잡을 거라고 생각했습니다. 재본 값은 반대였어요.
- SSD가 expert 크기로 읽을 때: 초당 17.3GB — 처음 잡았던 초당 5~7GB보다 훨씬 빠릅니다
- slot에 써 넣는 속도: 초당 49~75GB
- 그런데 생성은 초당 11.2토큰에서 멈춥니다
막히는 지점은 계산 쪽이었습니다. batch 1짜리 양자화 행렬곱이 초당 47.2GB밖에 안 나오는데, 이 기계의 메모리 대역폭은 초당 235.1GB예요. 20%밖에 못 씁니다. 디스크에서 못 읽어 와서가 아니라 계산 명령을 띄우는 데서 막힙니다.
문서에는 이렇게까지 적어뒀습니다. cache가 하나도 안 맞아도 IO만으로는 초당 13토큰이 나오므로, 작은 맥을 묶는 건 대역폭이 아니라 메모리와 계산이라고요. 처음 계획에서 작은 맥을 초당 1~4토큰으로 잡았던 건 IO 축에서는 너무 비관적이었다고 스스로 적었습니다.
단서가 하나 더 있습니다. SSD가 빠른 건 expert 하나를 한 덩어리로 읽을 때고, 작은 조각을 하나씩 읽으면 100배 나빠집니다. 그래서 기록을 얼마 크기로 자르느냐가 이 프로젝트의 거의 전부입니다.
자기가 틀리게 잰 것도 지우지 않았습니다
제일 눈에 남은 건 이 대목입니다. slot 쓰기 속도를 처음 쟀을 때 초당 1.54GB가 나와서 관문을 통과 못 한 것처럼 보였다고 합니다. 원인은 벤치마크 쪽이었어요. expert 하나마다 mx.eval()을 불러서, 복사가 아니라 쓰기마다 GPU를 동기화하는 비용을 잰 것이었습니다.
고친 뒤에는 초당 49~75GB가 나왔어요. 그런데 틀린 첫 번째 스크립트를 지우지 않고 경고 삼아 저장소에 남겨뒀다고 적어뒀어요.
디스크 속도도 두 번 틀렸더군요. 방금 쓴 파일을 읽으니 초당 28.8GB가 나왔는데, 파일이 통째로 버퍼 cache에 있어서 나온 값이었습니다. F_NOCACHE는 이미 cache에 있는 페이지를 쫓아내지 않는다는 걸 그때 알았다고 합니다. 세 번째에야 같은 자리를 두 번 읽지 않는 방법으로 다시 쟀어요.
README 문체를 두고 싸움이 붙었습니다
기술 이야기만 있는 스레드가 아니었습니다. 댓글 여러 개가 README 문체를 지적했어요.
drcongo는 "디스크가 먼저 무는 관문이다"를 인용하고 AI;DR 이라고 적었습니다. embedding-shape는 지금 README가 프로젝트 소개가 아니라 작업 일지를 쏟아놓은 것에 가깝다고 했고요. Eufrat은 이 문체가 흐름을 이해하지 못한 채 엉뚱한 자리에 끼어들어서 읽기가 극도로 짜증난다고 했습니다.
만든 사람은 매번 고치겠다고 답했어요. AmazingTurtle이 이미 같은 걸 하는 저장소 다섯 개를 나열하며 힘을 합치라고 했을 때는 이렇게 답했어요.
제가 조사를 안 한 것처럼 보이게 만드는 말이라 유감입니다. 저는 엄청나게 많이 했습니다. 고치려면 벤치마크·비교 표를 넣겠습니다.
반대편에는 mannyv가 있었습니다. 여러 사람이 같은 걸 해도 괜찮고, 처음부터 문제를 붙들고 씨름한 사람한테서 남들이 생각 못 한 게 나올 수 있다고요. 기존 프로젝트에는 접근 방식이 이미 구워져 있어서 그게 안 나온다는 겁니다.
저는 mannyv 쪽으로 기울었습니다. 27.6MB 대 471.9MB 같은 기록은 남의 코드를 받아 고치는 자리에서는 안 나왔을 것 같아서요.
그래서 우리 3090에서도 되나
열쇠 하나가 아무 자물쇠에나 맞지는 않습니다. 이 방법은 MoE 구조에만 들어갑니다.
안 됩니다. 이유가 둘인데 두 번째가 진짜입니다.
첫째, 맥 전용입니다. 저장소에 unified memory6가 있어야 한다고 못 박아뒀고, 카드에 따로 붙은 메모리로는 구조를 다시 짜야 한다고, 외장 그래픽카드는 지금 엔진에 없다고 적어뒀습니다.
둘째, 저희가 겪은 30.4GB 문제는 MoE가 아니었습니다. 이미지 생성 모델은 layer를 골라 쓰지 않습니다. 매번 전부 씁니다. 512개 중 10개만 켜지는 구조여야 나머지 502개를 밖에 둘 수 있는 건데, 저희 모델은 그렇게 안 생겼어요.
그러니까 이건 메모리가 모자랄 때 쓰는 만능 열쇠가 아니라 MoE 구조에만 맞는 열쇠입니다. 저희 자물쇠에는 안 들어갑니다.
지금 생각
숫자만 보면 초당 11토큰짜리를 쓰려고 105GB를 받고 110GB를 비워둘 이유가 별로 없습니다. 만든 사람 본인도 이번 회차에 이 48GB 맥에서 모델 전체를 끝까지 한 번 생성해본 적이 없다고 문서에 적어뒀어요.
그런데 이 프로젝트에서 얻어갈 게 있다면 속도가 아니라 재고 적어두는 방식인 것 같습니다.
표 바로 아래에 실측이 세 배 낮았다고 적어둔 것, 틀리게 잰 벤치마크를 지우지 않고 남겨둔 것, 빌려 쓴 metallib이 버전이 어긋나 있어서 출시 전략이 될 수 없다고 스스로 적은 것. 저희가 실측 글을 쓸 때 참고할 만한 태도라고 봅니다.
실제로 얼마나 쓸 만한지는 맥이 있어야 알 것 같습니다. 저희한테는 없어서, 그 부분은 직접 돌려본 사람들 기록을 옮기는 데서 멈췄습니다.
글에 나온 말
- layer — 모델을 이루는 계산 단계 한 층. 이 모델은 48층이고 입력이 아래에서 위로 지나간다.
- token — 글을 잘게 나눈 조각. 대개 단어의 일부다. 초당 토큰 수(tok/s)로 생성 속도를 잰다.
- expert — MoE 모델 안에 나뉘어 들어 있는 작은 계산 덩어리. 전부 쓰지 않고 입력에 따라 몇 개만 골라 쓴다.
- MoE — Mixture of Experts. 모델을 여러 expert 로 쪼개두고 필요한 것만 켜는 구조. 전체 크기는 큰데 한 번에 쓰는 양은 적다.
- slot pool — 크기를 미리 정해둔 메모리 칸 묶음. 여기에 expert 를 읽어 넣고 다 차면 안 쓰는 것을 밀어낸다. 그래서 쓰는 메모리가 정해진 선을 안 넘는다.
- unified memory — CPU 와 GPU 가 같은 메모리를 나눠 쓰는 애플 실리콘의 구조. 그래픽카드에 메모리가 따로 붙은 PC 와 다르다.
참고 자료
- carloslfu/slotstream — 공식 저장소. 파라미터 수, 파일 크기, 전문가 개수, 속도 표기를 여기서 확인했습니다. MIT
- Show HN 스레드 — 댓글을 읽는 데 썼습니다. 2026년 9월 6일 기준 235점, 댓글 115개
- MindStudio — SSD 스트리밍 개념 정리 — 원리를 이해하는 데 도움이 됐습니다. 필자가 직접 돌려본 기록은 아닙니다
- Qwen — 대상 모델을 배포한 곳